 dwisniewski.com
Context Mapping – kolejny element skrzynki narzędziowej DDD
W strategicznym Domain-Driven Design (DDD) wyróżniamy kilka kluczowych elementów. Jednym z nich jest Context Mapping. Bounded Contexty mogą, a nawet muszą się ze sobą komunikować. To integralna część projektowania systemów. Dziś przyjrzymy się rodzajom mapowań i opiszemy je na przykładach z prawdziwego świata.
Miejsce w DDD
DDD dzielimy na dwie części. Strategiczne DDD zajmuje się decyzjami wysokiego poziomu: definiowaniem kontekstów, wszechobecnym językiem (ubiquitous language) i komunikacją między komponentami (bounded contextami). Taktyczne DDD rozkłada z kolei na części elementy znajdujące się wewnątrz bounded contextów. To spore uproszczenie, ale na potrzeby tego wpisu możemy przyjąć, że to wystarczająca wiedza, by zrozumieć, gdzie w tej całości mieści się Context Mapping.
Źródła
Pomocna w tym temacie literatura to przede wszystkim tzw. „niebieska książka” Erica Evansa oraz „DDD Distilled” Vaughna Vernona. Jako uzupełnienie możemy wykorzystać repozytorium DDD Crew.
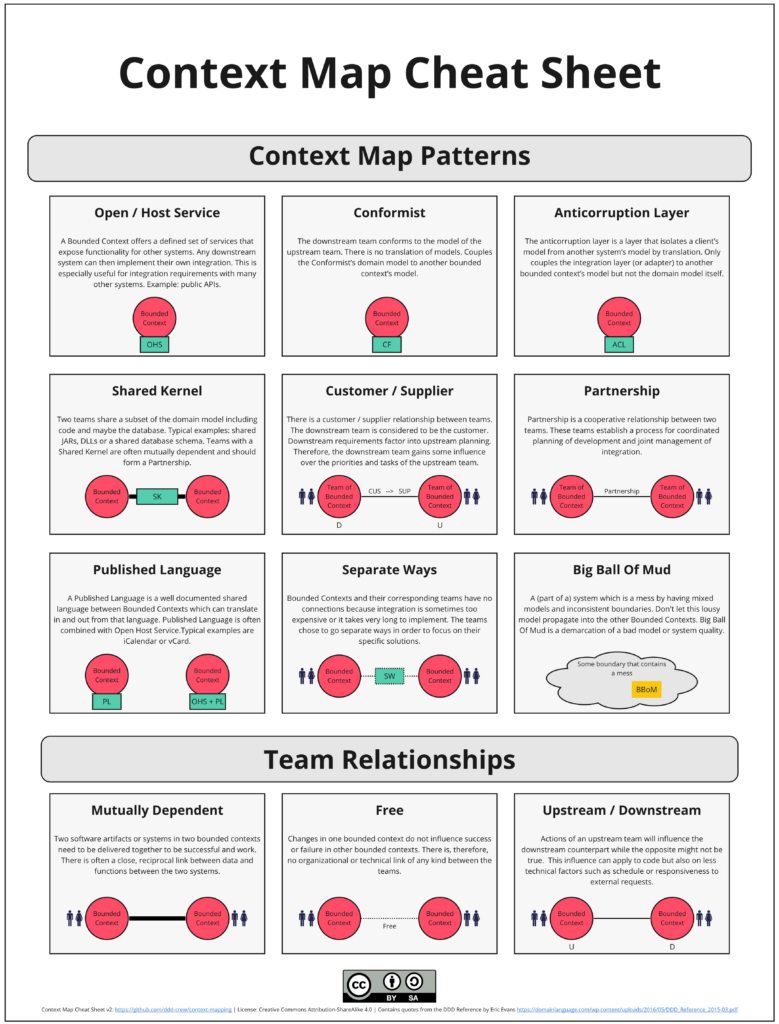
Mógłbym zakończyć artykuł, po prostu podlinkowując te źródła. Chcę jednak rozwinąć definicje o przykłady z prawdziwego biznesu. To właśnie najtrudniejsza część uczenia siebie i innych DDD. Niewiele firm dzieli się swoimi praktykami, a my opieramy się głównie na teoretycznych przykładach proponowanych przez edukatorów. Dziś spróbujemy przełamać ten schemat i omówić Context Mapping w bardziej praktyczny sposób.
Open / Host Service
W tej sytuacji jeden Bounded Context otwiera swoje API i pozwala zależnym serwisom/modułom korzystać z niego na podstawie (zwykle) dokumentacji API, wystawiając na zewnątrz język swojego kontekstu, ale nie reagując na specyficzne wymagania swoich klientów. To najczęstszy model, zwłaszcza w aplikacjach mikroserwisowych, w których Bounded Contexty komunikują się ze sobą przez REST API.
Przykładem z życia może być Spotify albo inna platforma streamingowa. Załóżmy, że jednym Bounded Contextem jest Katalog, a drugim Odtwarzacz. W tej sytuacji Katalog wystawia swoje API lub fasadę (jeśli to monolit). To typowy scenariusz, w którym Odtwarzacz może po swojej stronie dowolnie wykorzystywać dane dostarczane przez Katalog, ale wyłącznie przez publiczny kontrakt API. Jest to szczególnie przydatne, gdy chcemy, by część naszego systemu była publicznie dostępna.
Conformist
W tym typie mapowania mamy do czynienia z relacją upstream → downstream. Ściśle wiąże ona konformistyczną część systemu (BC) z upstreamem. Można powiedzieć, że decyzje podejmowane przez upstream mogą zepsuć wszystko w downstreamowym BC, co opiera się na kontrakcie z upstreamem. Downstream nie ma w tym obszarze własnego modelu domenowego i bezpośrednio przejmuje model upstreamu, akceptując ryzyko jego zmian.
Przykładem z życia może być dowolna aplikacja korzystająca z API Amazona. Amazon zmienia swoje API? Łamie wsteczną kompatybilność? Musisz się dostosować. W takim przypadku jasne i przewidywalne zachowanie dostawcy API jest kluczowe, by nadążać za zmianami w systemie upstream.
To jednak dotyczy komunikacji z zewnętrznym modułem. Żeby lepiej to zilustrować na przykładzie dostawcy wewnątrz naszej organizacji, weźmy dowolną firmę produktową. Niech upstreamem będzie BC User Management, którego właścicielem jest centralny zespół platformowy. Model powinien zawierać podstawowe encje: User, Role, Permission oraz Value Object Status. Załóżmy też, że zespół odpowiedzialny za ten BC ma silną pozycję w firmie albo jego Tech Lead blisko współpracuje z zarządem.
Jako serwis downstream weźmy w tym przykładzie Bounded Context o nazwie Billing. Billing jako klient potrzebuje informacji o użytkownikach; nie jest właścicielem tożsamości użytkownika i nie ma budżetu ani mandatu, by stworzyć własny model (np. z powodu braków kadrowych).
W praktyce oznacza to, że moduł Billing zaimportuje DTO z User Management i będzie ich używał bezpośrednio. Pola takie jak user_id, role czy status (i wiele innych) będą przechowywane w dokładnie tej samej postaci. Nie ma tu żadnego mapowania ani tłumaczenia.
Jeśli pewnego dnia BC User Management zmieni nazwy statusów, semantykę ról albo usunie pole z modelu, model Billingu – mówiąc potocznie – „się wysypie”. Co ważne, w tym typie mapowania jest to akceptowalne. Zwykle dlatego, że koszt izolacji byłby większy niż koszt dostosowania. Świadczy to też o tym, że zespół Billingu ma mniejszy wpływ na ogólną strategię firmy.
ACL (Anti-Corruption Layer)
ACL (warstwa antykorupcyjna) działa jako warstwa pośrednia między dwoma Bounded Contextami. Jej celem jest ochrona modelu downstream przed „zanieczyszczeniem” językiem używanym w kontekście upstream oraz zapewnienie odporności na zmiany – choć ta odporność wciąż jest ograniczona.
W porównaniu z opisanym wyżej modelem Conformist główne różnice, poza większą inwestycją przy implementacji downstreamowego BC, to:
- Downstream nie przyjmuje modelu upstreamu.
- Downstream ma własny język domenowy.
- Integracja odbywa się przez tłumaczenie, a nie bezpośrednie użycie modeli.
Przykładem z życia jest system obsługujący rozliczenia subskrypcji, korzystający z bramki płatniczej lub systemów płatności takich jak Stripe. Typowa struktura danych w takich systemach to: Customer, Invoice, PaymentIntent i Subscription. API zmienia się stosunkowo często, a terminologia również podlega istotnym zmianom.
Nasz Bounded Context, nazwijmy go Billing, może używać zupełnie innej terminologii, np.: Payer, Charge, BillingPeriod, Settlement. W tym przypadku zespół Billingu nie chce, by semantyka i konwencje nazewnicze przeciekały do jego modelu (bo jeśli zmienimy dostawcę płatności, możemy mieć problem, a zmiana przecieknie do naszego modelu).
Tworzymy wtedy ACL, czyli warstwę mapującą dane z systemu płatności. Klasa korzystająca z API mogłaby się nazywać np. BillingPaymentAdapter, a do niej dodajemy PaymentMapper, który pełni rolę naszego ACL. Dla jasności zamieszczam diagram:
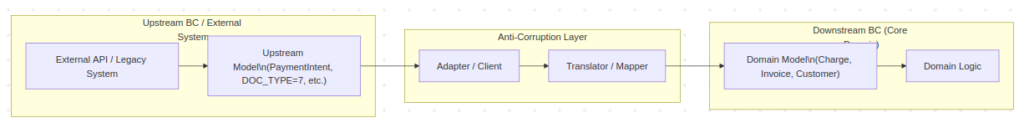
Jak widać powyżej, nasz model downstream jest całkowicie niezależny od Stripe'a czy innego dostawcy. Oto dobra wskazówka implementacyjna: ACL (Anti-Corruption Layer) powinien znajdować się w warstwie infrastruktury, jeśli używamy architektury heksagonalnej lub jej odpowiednika w innych podejściach. Zgodnie z dobrymi praktykami (zasady SOLID) zależności powinny płynąć tylko w jednym kierunku (domena nie powinna wiedzieć, że ACL tłumaczy dane z zewnętrznego systemu). Niedopuszczalne jest na przykład tworzenie zależności domena → infrastruktura albo domena → Stripe SDK. Domena w naszym kodzie powinna znać jedynie interfejs klasy ACL (np. PaymentProviderPort).
Shared Kernel
W niektórych sytuacjach chcemy, by wspólne części Bounded Contextów i ich modelu były świadomie wydzielone, ograniczone i współdzielone przez oba moduły. Kluczowe cechy to: kod we wspólnym jądrze (shared kernel) powinien być ograniczony do minimum, a jego utrzymanie wymaga koordynacji po obu stronach relacji (nie ma tu relacji upstream–downstream, raczej bardziej zrównoważona).
To mapowanie ma sens, gdy oba Bounded Contexty naprawdę dzielą to samo pojęcie i definicje, koszt duplikacji i synchronizacji jest wyższy niż koszt współdzielenia, a zespoły po obu stronach wiedzą, że zmiany trzeba koordynować wspólnie.
Jako przykład weźmy aplikację biznesową z modułami: Identity i Audit. Moduł Identity odpowiada za użytkowników, role, uprawnienia i polityki dostępu – typową funkcjonalność wielu platform B2B. Moduł Audit prowadzi dziennik zdarzeń, rejestrując, kto i kiedy wykonał daną akcję, a także spełnia wymagania prawne, takie jak ISO czy SOC2.
W obu kontekstach UserId i TenantId będą wspólnymi pojęciami. Oznacza to, że reguły walidacji, semantyka i Value Objecty będą współdzielone – na przykład Value Object o nazwie Permission. W shared-kernelu (jeśli to modularny monolit) możemy umieścić następujące klasy:
shared-kernel/
    identity/
        TenantId
        UserId
    security/
        Permission
    time/
        Clock
W powyższym kodzie widzimy, że wspólne części obu modeli będą kontrolowane przez oba zespoły. Każda zmiana w TenantId musi przejść review z obu stron, a żeby zapewnić kompatybilność po obu stronach relacji, trzeba napisać testy kontraktowe.
Shared Kernel jest zalecany tam, gdzie organizacja ma wysoki poziom dojrzałości, w tym wspólne code review, wspólne testy i jasny podział odpowiedzialności. Co więcej, zespoły muszą ściśle współpracować, mieć wspólne cele biznesowe i umieć uzgadniać zmiany w Shared Kernelu. Wyobraź sobie klasę Money. Jeśli zostanie zmieniona, zmiany najpewniej globalnie dotkną całej organizacji, więc wrażliwość na zmiany rozkłada się równo na wszystkie zespoły.
Trzeba jednak uważać, by nie przeładować Shared Kernela zbyt wieloma rzeczami. Powinien mieć ograniczoną odpowiedzialność, zredukowaną do minimum, a sprawy, które obejmuje, powinny być marginalne dla korzystających z niego Bounded Contextów. Idealnie Shared Kernel powinien być mały, wolno się zmieniać i zawierać Value Objecty, a nie złożone procesy czy encje. Dobrze też, jeśli nie ma zależności od infrastruktury – to znacząco upraszcza projektowanie i kodowanie. Gdy rozbieżność definicji jest groźniejsza niż sprzężenie, używamy Shared Kernela. W pozostałych przypadkach warto rozważyć inne rodzaje mapowań.
Published Language
Trzeba przyznać, że ta forma mapowania ma czasem wiele wspólnego z Open/Host Service. Mam na myśli przede wszystkim formę współpracy między zespołami. Jeden zespół udostępnia przestrzeń z dokumentacją, z której inne Bounded Contexty czerpią informacje o konwencjach nazewniczych, dokumentację interakcji i szczegóły procesów udostępnianych przez API. Spójrzmy na świetny przykład pokazujący różnicę.
OHS bez PL: Bank udostępnia API do przelewów. Endpoint /transfers przyjmuje JSON z polami sender_account_id, recipient_account_id, amount_in_cents i currency_code. To OHS – API jest otwarte i udokumentowane. Ale jeśli za 6 miesięcy bank zmieni amount_in_cents na amount_minor_units, wszyscy klienci będą musieli się dostosować. Każdy system downstream tłumaczy te dane na własny język domenowy.
OHS + PL: Ten sam bank, ale wdraża standard ISO 20022 dla płatności. Używa precyzyjnie zdefiniowanych typów, takich jak CreditorAccount, InstructedAmount i PaymentIdentification, ze schematu XML/JSON określonego przez międzynarodowy komitet. Teraz semantyka jest wspólna i stabilna. Gdy Visa, Mastercard i SWIFT używają tego samego ISO 20022, wszyscy mówią tym samym językiem. Zmiana wymagałaby ratyfikacji nowej wersji standardu przez komitet.
Podsumowując różnice:
Open Host Service działa na poziomie architektury integracji (JAK wystawiamy usługi: REST, gRPC, polityka dostępu), a Published Language na poziomie semantyki domeny (CO oznaczają dane: standaryzacja słownictwa, zarządzanie kontraktem). To nie są „wzorce stosowane razem”, tylko ortogonalne wymiary – możesz mieć otwarte API z własnym dialektem (OHS bez PL) albo zamknięty standard ISO 20022 tylko dla partnerów (PL bez OHS).
Spójrzmy na wizualizację:
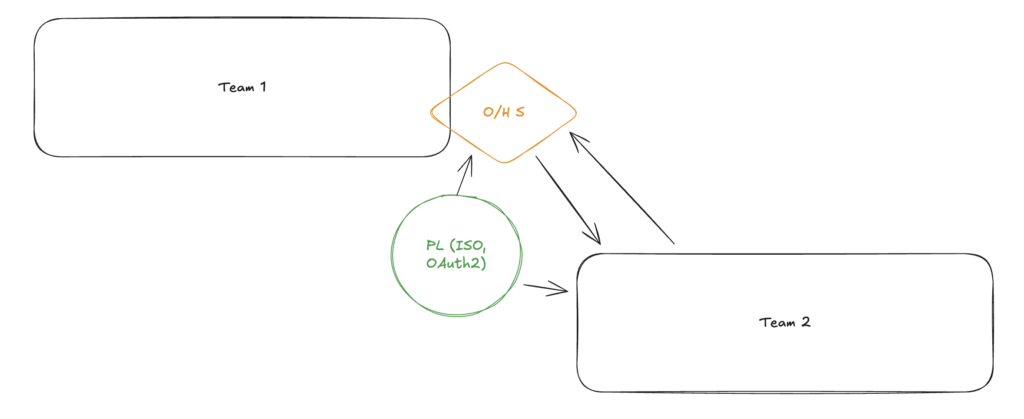
Koncepcja jest więc bardzo prosta. Weźmy na przykład aplikacje używające OAuth2 do uwierzytelniania/autoryzacji użytkowników. Gdy logujesz się do aplikacji kontem Google, działa Published Language OAuth:
access_token– token dostępurefresh_token– token odświeżaniascope– zakres uprawnień
Ten język jest opublikowany jako standard i każdy rozumie go tak samo – czy to Facebook, Google, czy GitHub. Dzięki temu przy otwartym API możemy łączyć się bezpośrednio z wymienionymi usługami właśnie za sprawą tego języka, opublikowanego jako powszechnie znany standard.
Separate Ways
Ten format mapowania zakłada, że integracja między komponentami (BC) nie jest potrzebna, a w niektórych przypadkach wręcz niemożliwa. W takim scenariuszu na potrzeby danego kontekstu możemy swobodnie duplikować wszechobecny język, pisać własne rozwiązania, procesy i algorytmy, bo inny zespół nie ma wglądu w zmiany i założenia realizowane przez nasz projekt ani nie jest nimi zainteresowany.
Czasem łatwiej napisać własny pakiet/moduł, niż integrować się z wewnętrznym lub zewnętrznym komponentem biznesowym. Przykładem może być system ERP dla firmy produkcyjnej.
Kontekst 1: Planowanie produkcji
- Zarządza harmonogramem produkcji.
- Przydziela maszyny i operatorów.
- Śledzi postęp zleceń produkcyjnych.
- Ma własną definicję „Zlecenia” = zlecenie produkcyjne z datami i maszynami.
Kontekst 2: Kontrola jakości
- Ma własną definicję „Zlecenia” = partia produktów do kontroli.
- Przeprowadza kontrole produktów.
- Rejestruje wady i niezgodności.
- Generuje raporty jakości.
W tym przypadku zlecenie to coś zupełnie innego, a planowanie produkcji nie jest ściśle powiązane z kontrolą jakości. Powody takiego rozdzielenia mogą być różne: na przykład obecne rozwiązanie „działa, więc go nie ruszamy”, różne zespoły, różne systemy legacy (planowanie produkcji korzysta ze starego modułu SAP z 2005 roku, a kontrola jakości ma własny system kupiony od innego dostawcy w 2018 roku), różne modele danych albo różne rytmy pracy Bounded Contextów.
Załóżmy, że koszt napisania integracji to 200 000 zł. Powiedzmy, że to 7 miesięcy pracy jednego programisty na kontrakcie B2B – na podstawie średnich zarobków seniorów; zachęcam do lektury mojego poprzedniego artykułu o sytuacji na polskim rynku IT.
Pytanie, które warto zadać przy tego typu problemach, brzmi: czy warto integrować dwa serwisy, jeśli jedyną korzyścią będą na koniec ładne diagramy od architektów? Oczywiście to uproszczenie, ale w tym konkretnym przypadku nie ma sensu integrować czegoś, co w biznesie naturalnie działa zupełnie niezależnie. Mam nadzieję, że to w pewnym stopniu ilustruje przypadki użycia.
Big Ball of Mud (raczej antywzorzec)
Och, mógłbym o tym pisać godzinami. W mojej 10-letniej karierze to właśnie z tym typem mapowania spotykałem się najczęściej. Efekty modelowania Bounded Contextów w ten sposób są zwykle przeciętne, jeśli nie wprost fatalne. Prowadzi to do pomieszanych agregatów, nadmiernego sprzężenia, dużej ilości wiedzy ukrytej w głowach programistów i trudności z uzyskaniem testowalnego kodu.
To właściwie tylko uproszczony przegląd. Trzeba pamiętać, że większość aplikacji biznesowych czy B2B będzie miała podsystemy zbudowane w ten sposób. Bardzo często kod w tych podsystemach będzie kluczowy dla działania aplikacji. Aby rozwiązać problem związany z tym mapowaniem, trzeba w miarę możliwości rozbić dużą „kulę błota” na mniejsze, bardziej zrozumiałe Bounded Contexty. Czasem jedyną drogą jest tworzenie nowych Bounded Contextów dla nowych funkcjonalności i oddzielanie ich od „Big Ball of Mud” za pomocą omówionego wyżej ACL (Anti-Corruption Layer).
Myślę, że temat „Big Ball of Mud” omówię w osobnym artykule poświęconym systemom legacy i sposobom ich modernizacji. Zapraszam więc do śledzenia bloga – może się tu pojawić wiele ciekawych historii opartych na prawdziwych przykładach (oczywiście zanonimizowanych) z moich wcześniejszych projektów.
Nie wszystkie tematy zostały omówione
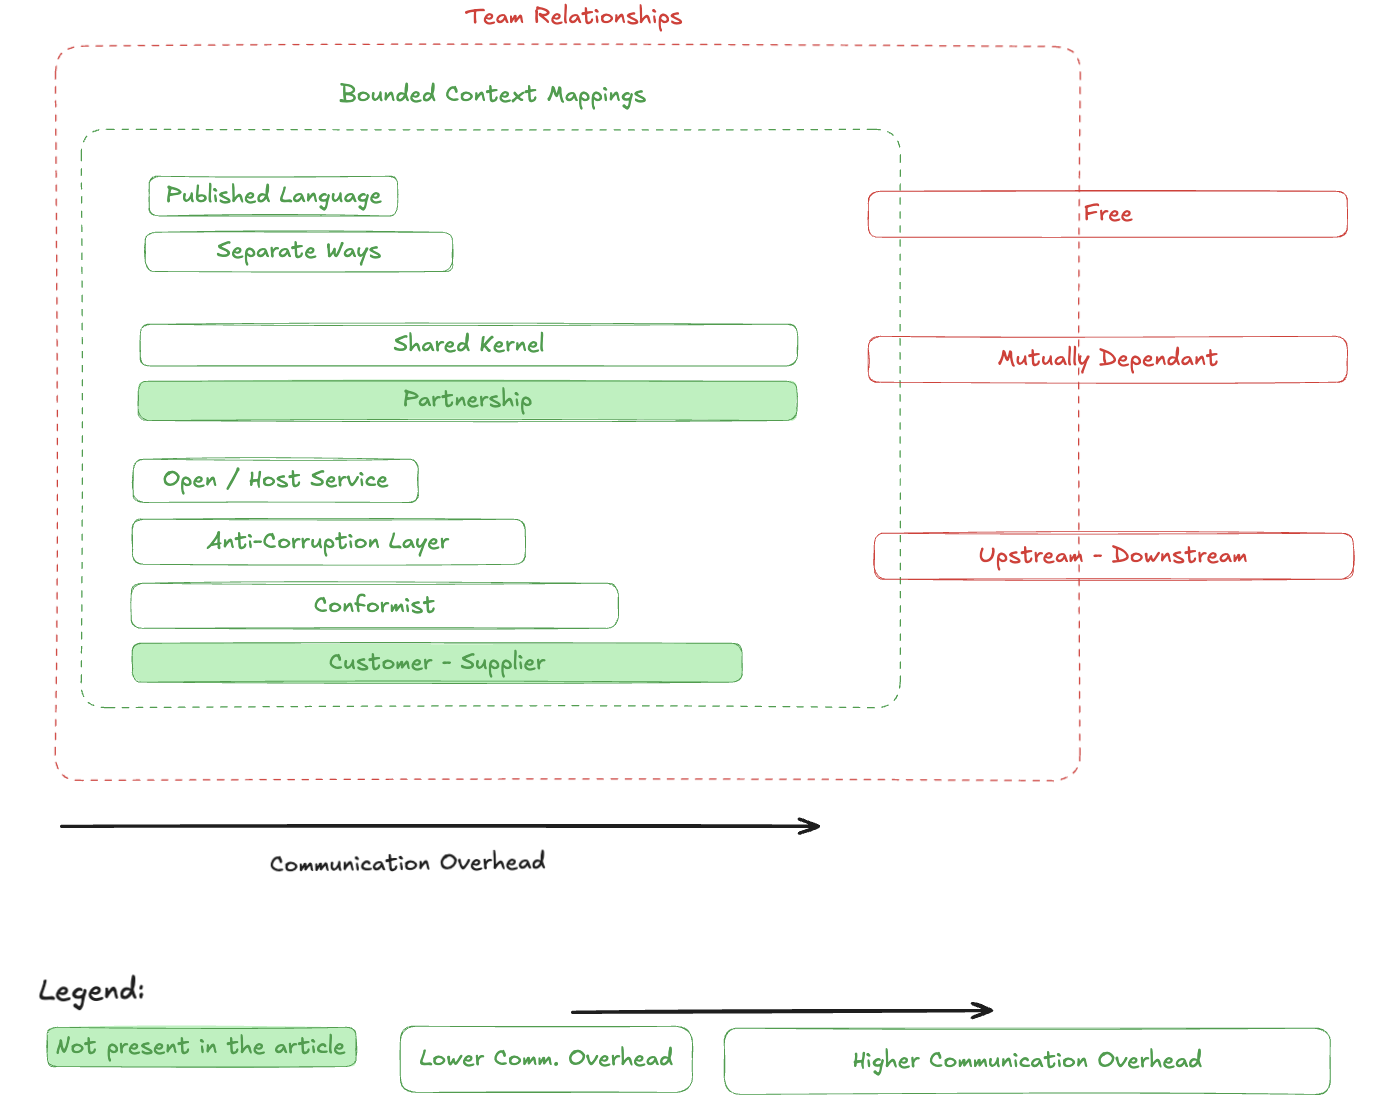
W źródłach wymienionych we wstępie można zauważyć pewną niejednoznaczność wokół Bounded Contextów i lekkie mieszanie tego pojęcia z typami relacji między zespołami. Żeby wprowadzić więcej struktury, stworzyłem własny diagram, który oddziela zależności Bounded Contextów od relacji między zespołami. Te pojęcia są ze sobą bardzo blisko związane, ale mam wrażenie, że w książkach i materiałach, które czytałem, to rozróżnienie nie zostało jasno przeprowadzone. To po prostu moja interpretacja dostępnej literatury. Spójrzmy na poniższy obraz:
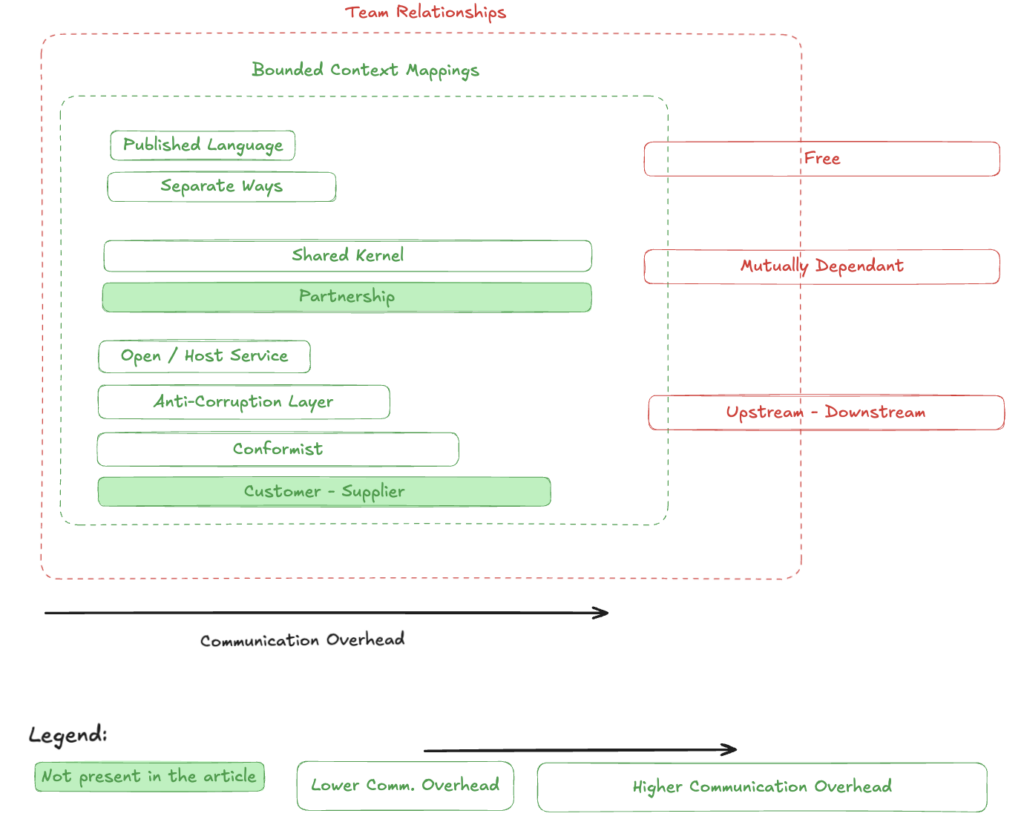
Jak widać, w tym wpisie nie omówiłem dwóch wariantów:
- Customer-Supplier
- Partnership
Zrobiłem to celowo. W moim rozumieniu Context Mappingu relacje Customer-Supplier i Partnership dotyczą bardziej komunikacji między zespołami niż technicznych warunków, na jakich zespoły się łączą. Uważam, że ich nazwy mówią same za siebie i nie ma potrzeby wchodzić w szczegóły. Komunikacją między zespołami zajmę się w osobnym artykule, w którym uwzględnię powyższe punkty i dokładniej omówię czerwone bloki z diagramu.
Kolejnym elementem legendy jest strzałka opisująca narzut komunikacyjny między zespołami. Dość dokładnie oddaje ona, jak bardzo musisz koordynować działania z zespołem utrzymującym sąsiedni komponent biznesowy i ile spotkań/wiadomości będziesz musiał z nim wymienić. W niektórych przypadkach będzie to istotne kryterium, na przykład tam, gdzie komunikacja nie jest dobrze rozwinięta.
Gdy spojrzymy na moją wizualizację, widzimy, że zielony obszar jest zagnieżdżony w czerwonym. Opisuje to też pewną hierarchię w podziale zadań. Najpierw z wyższego poziomu patrzymy na komunikację między zespołami (albo – jeśli jeden zespół odpowiada za wiele zdolności biznesowych – na komunikację wewnątrz tego zespołu), a dopiero potem schodzimy na poziom mapowań. Tak to widzę i tak to sobie układam w głowie.
Podsumowanie
Mam nadzieję, że opisałem temat Context Mappingu w miarę przejrzyście. Z perspektywy strategicznego DDD to bardzo ważny element projektowania na poziomie systemu. Wiele źródeł, prezentacji i książek opisuje mapowanie kontekstów bardzo ogólnie. Próbowałem się od tego oderwać i pokazać przykłady aplikacji i systemów, z którymi stykamy się w codziennej pracy czy w życiu.
Trzeba jednak pamiętać, że na poziomie enterprise Context Mapping to nie tylko ćwiczenie techniczne, ale przede wszystkim potężne narzędzie polityczne. Każda linia na mapie – czy to Customer-Supplier, czy Conformist – odsłania faktyczny układ sił w organizacji i przepływ decyzji. Jako architekci musimy mieć świadomość, że wybór wzorca często wynika nie z elegancji kodu, lecz z hierarchii budżetowej albo gotowości zespołów do współpracy. Mapowanie kontekstów pozwala jawnie nazwać te napięcia, zamieniając architekturę z teoretycznego diagramu w realną strategię poruszania się po strukturze władzy w firmie.
Jeśli nie zgadzasz się z moimi argumentami, zauważysz niedoskonałości albo chcesz dalej podyskutować o temacie, śmiało komentuj. Najwięcej uczymy się przez wymianę myśli. Nic nie jest wyryte w kamieniu. Metodyki i koncepcje mogą się zmieniać – ważne, by nadążać za zmianami na rynku i dostosowywać definicje do otaczającego nas świata, nigdy odwrotnie!
Do następnego razu!