 dwisniewski.com
S3 + Snowflake + DBT - Potężna broń do analizy danych
W dzisiejszym świecie wiele firm zmaga się z problemem analizy danych. To dane są kluczowym elementem podczas podesjmowaina biznesowych decyzji (a przynajmniej powinny). Aby efektywnie te dane przedstawić, musimy je najpierw odpowiednio zamodelować. W dzisiejszym poście spróbujemy "zareklamować" rozwiązanie które w moim zespole ułatwia nam codzienną prace z danymi. Zapraszam do przeglądu artykułu i dzieleniu się wnioskami w komentarzach.
Pozyskiwanie danych
Na potrzeby dzisiejszego wpisu, założymy, że dane mogą spływać do s3 (magazyn danych od AWS) z wielu różnych źródeł w wielu różnych formatach. Spójrzmy na grafikę poniżej aby mniej więcej zrozumieć jak to działa od strony pozyskania danych.
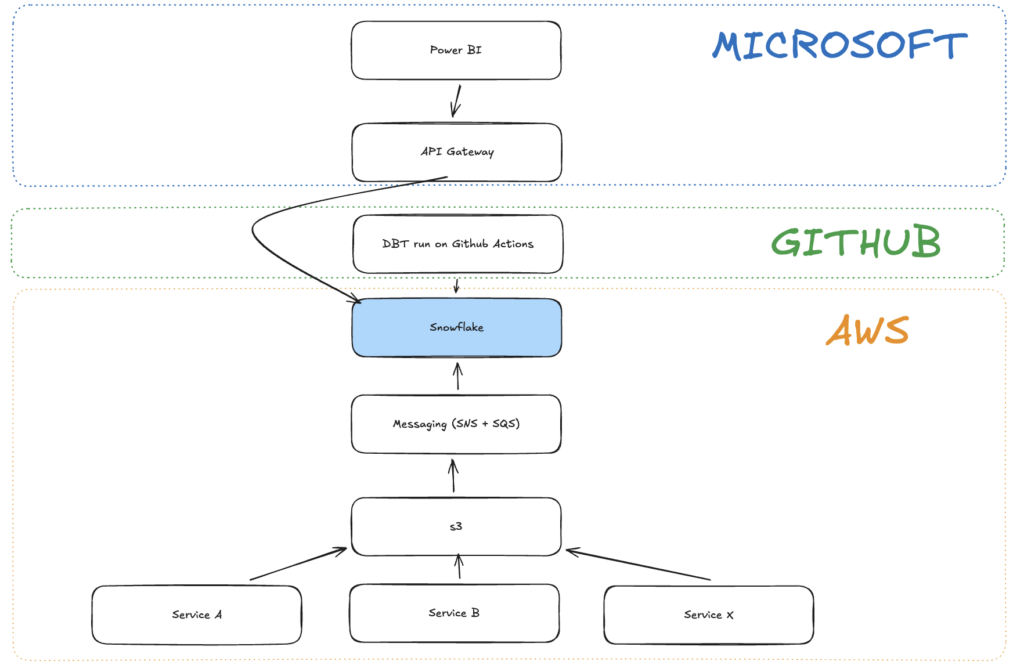
Komunikacja S3 -> Snowflake
To jest dość ważna część całego ekosystemu. To ten element automatyzuje i zdejmuje z ciebie odpowiedzialność za płynny przepływ danych z S3 do Snowflake. Wejdźmy trochę głębiej w ten element i najlepszy sposób konfiguracji. Z racji tego, że Snowflake leży na infrastrukturze AWS, konfiguracja i komunikacja pomiędzy serwisami jest ułatwiona. Snowflake wspiera to w bardzo sprytny sposób. Poniżej pokażę diagram przepływu który fajnie to prezentuje. To wyjaśni wam całą magię stojącą za tym setupem, który osobiście bardzo lubię i stosuję w projektach domowych jak i komercyjnych.
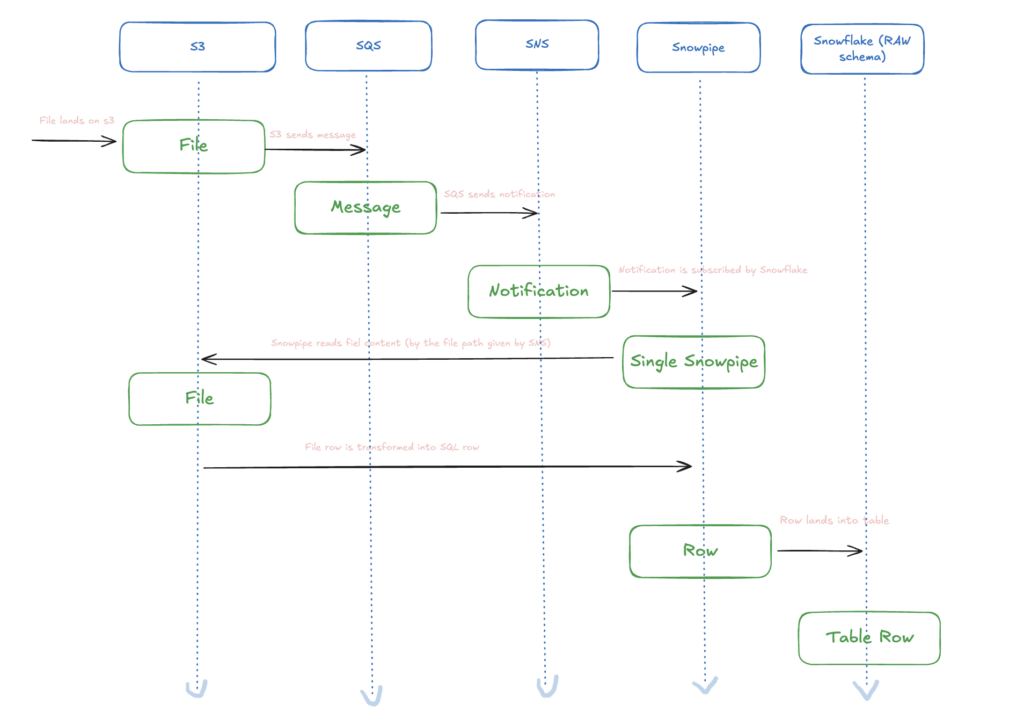
Krótki komentarz do powyższego diagramu. Zaczynamy od momentu kiedy plik ląduje fizycznie w naszym systemie plików. W s3 mamy opcję wysyłania do kolejki SQS wiadomości kiedy wystąpi dany event: plik dodany, plik usunięty, plik zmodyfikowany etc. To pozwala nam stworzyć podstawy systemu reaktywnego.
Kolejny krok to transpozycja wiadomości w kolejce SQS na notyfikację w SNS. Amazon SNS (Simple Notification Service) to usługa chmurowa AWS, która umożliwia wysyłanie powiadomień z aplikacji do wielu odbiorców jednocześnie. Działa na zasadzie publikowania wiadomości do "tematów" (topics), a następnie dostarczania ich do wielu subskrybentów. SNS może wysyłać powiadomienia przez różne kanały, takie jak: funkcje Lambda, SMS-y, E-maile, Powiadomienia push do aplikacji mobilnych, Zapytania HTTP/HTTPS, Kolejki SQS.
Snowpipe jako złote rozwiązanie
Dzięki istnieniu Snowpipes możemy zdefiniować sobie czego nasłuchujemy i co robimy z tą informacją. Nie lubię mówić bez przykładu więc zerknijmy na kod od razu:
CREATE OR REPLACE PIPE pipe_data_source_data_provider_domain_table
AUTO_INGEST = TRUE
AWS_SNS_TOPIC = 'arn:aws:sns:us-east-1:2472837483:name_of_the_sns_service'
AS
COPY INTO data_source_data_provider_domain_table (
data,
filename,
file_row_number,
file_last_modified
)
FROM (
SELECT
$1,
METADATA$FILENAME,
METADATA$FILE_ROW_NUMBER,
METADATA$FILE_LAST_MODIFIED
FROM @your_bucket/provider/prod/
)
FILE_FORMAT = (type = 'PARQUET')
PATTERN = '*_domain_.*/.*table/.*';
Kod jest dosyć prosty. To definicja PIPE, która ma kilka kluczowych elementów.
- Name - nazwa Snowpipe, która powinna definiować poprzez konwencję skąd bierzemy dane i dokąd one zmierzaja.
- SNS Topic - adres topica, który nasłuchujemy - ważne: musimy mieć uprawnienia nadane na jednostkę Snowflake - robimy to w konfiguracji roli w SNS. Nie będę tego pokazywał w tym wpisie gdyż jest to rzecz standardowa i można znaleźć wiele przykładów w internecie, dokumentacja Snowflake również dobrze to opisuje.
- COPY statement - część definicji, która mówi co kopiujemy, w jakiej postaci i skąd, to tez ma swoje subelementy:
- INTO - do której tabeli lądują dane
- FROM - jaki path mamy nasłuchiwać (filtrowanie wiadomości SNS) - staraj się zawężać FROM jak najbardziej możesz, zaoszczędzisz na skanowaniu s3 przez Snowpipe
- FILE FORMAT - jakiego rodzaju plików poszukujemy podczas nasłuchu
- PATTERN - pattern ścieżki pliku jakiego oczekujemy
Wszystkie te elementy tworzą żyjący byt, którego istnienie możemy sprawdzić i sprawdzić również historię za pomocą kwerend:
DESCRIBE PIPE XXX
oraz
SELECT * FROM TABLE(INFORMATION_SCHEMA.PIPE_USAGE_HISTORY( PIPE_NAME => 'MY_PIPE' ));Jest wiele sposobów aby monitorować działanie i status Snowpipes, natomiast na to poświęcimy osobny wpis. Zamysł myślę, że jest jasny i możemy przechodzić dalej.
Wiersz w tabeli
Efektem powyższych działań jest powstanie wierszy w tabeli docelowej, którą nazywamy RAW.name_of_the_table. To będzie najniższa warstwa w naszej instancji Snowflake. Będzie podstawą, z której będą czytać nasze tabele na poziomie DBT (lub innego narzędzia do analizy danych).
W momencie insercji wiersza do tabeli RAW możemy zgodnie z harmonogramem lub przez trigger uruchamiać Github Actions, które w naszym procesie ELT wykonuje krok transformacji. To, w jaki sposób zamodelować dane wysokopoziomo opisuje poniższy schemat:
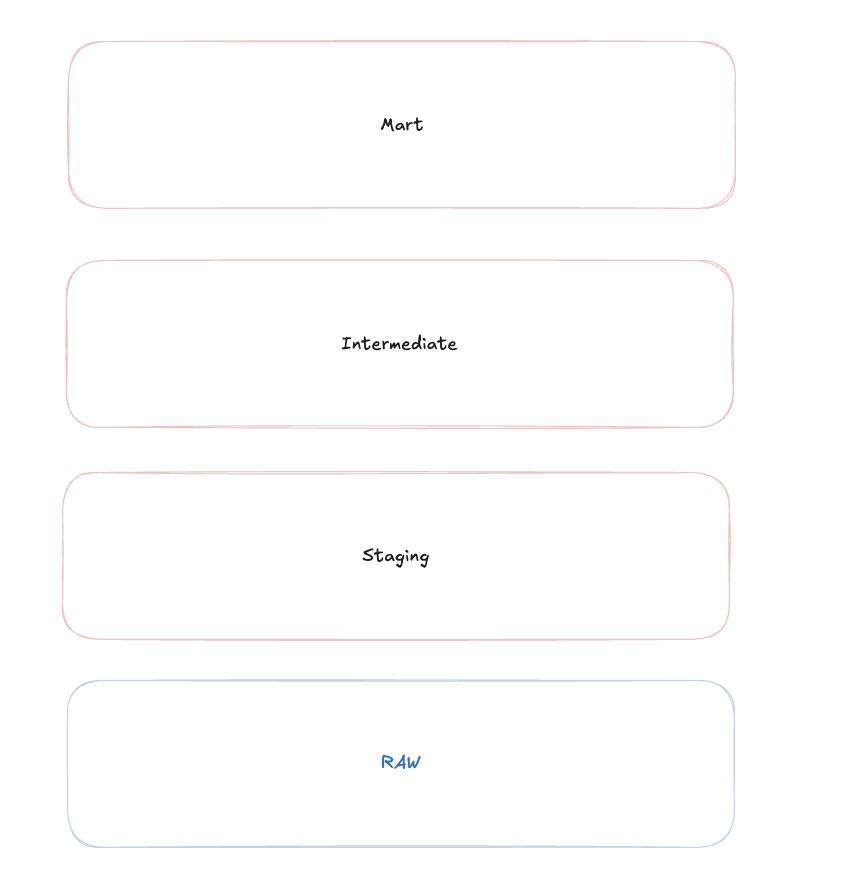
Szybkie wyjaśnienie. Nie musimy wcale używać metodologii jaką podałem: stg->int->mart. To kwestia konwencji i jest wiele rozwiązań typu medialion czy bronze->silver->gold. Można w nich przebierać. Tak nisko dziś nie będziemy schodzić ale pokazaliśmy prosty przykład w jaki sposób można te dane zamodelować.
Dane są zamodelowane
Kiedy już dane są zdatne do odczytu, możemy swobodnie przejśc do ich odczytu na wyższym poziomie. W naszym rozwiązaniu używamy PowerBi, jednakże do raportowania możesz użyć innych narzędzi takich jak: Tableau, Looker, Qlik Sense, Metabase, Apache Superset, Sisense, Domo. Na rynku jest obecnie mnóstwo narzędzi tego typu. Kwestia potrzeb twojej organizacji i jej możliwości.
Dla lepszego bezpieczeństwa dostęp powinien być tunelowany, najlepiej jest skonfigurować to w taki sposób aby pomiędzy instancja PowerBI a Snowflake było coś pośredniczącego, co kontroluje ruch danych pomiędzy platformami. To ważne i można to rozwiązać na wiele sposobów. Aby zastosować IP whitelisting na przykład, można skonfigurować API Gateway, który będzie naszym strażnikiem.
I oczywiście lekko utrudnia to pracę przy tworzeniu raportów, bo zespół musi być na to przygotowany i ich lokalne komputery muszą być ustawione w taki sposób aby łączyć się poprzez VPN oraz trzeba pilnować dostępu poprzez login/password (wygaszane) lub SSO. To sprawia zawsze problemy w utrzymaniu ale w nagrodę mamy bardzo bezpieczny i hermetyczny system. Więcej detali opiszę w innym artykule. Dziś podejmujemy temat z bardzo wysokiego poziomu i nie chcę napisać tutaj księgi z zakresu security. To zresztą nie jest do końca moja specjalizacja więc muszę się doedukować.
Wreszcie raporty
Na końcu tej ścieżki mamy zawsze warstwę, która prezentuje dane. To najprzyjemniejsza część dla biznesu, ponieważ z ich perspektywy nasz system to PowerBI. Nie muszą I NIE POWINNI być uświadamiani o detalach technicznych. To nasz problem i odpowiedzialność jako zespół techniczny aby te szczegóły implementacyjne przed nimi ukrywać.
Dla biznesu możemy stworzyć system raportów, analiz, aplikacji, która pomogą im w robieniu codziennych działań operacyjnych i podejmowaniu decyzji. To jest naszym celem, nie stworzyć technicznego potworka ale dawać wartośc biznesowi. Jeśli stakeholderzy korzystają z naszych rozwiązań powinniśmy być zadowoleni. Jeśli nie to czeka nasz długa droga rozwiązania tego problemu. O tym też się kiedyś rozpiszę bo to jest temat rzeka.
Podsumowanie
Jeśli dobrnąłeś do końca to świetnie. Na dziś to wszystko. Mam nadzieję, że powyższy schemat trochę rozjaśnił Ci cel i środki jakie chcemy podjąć. Jakie problemy konkretnie rozwiązujemy i dlaczego jest to rozwiązanie bardzo atrakcyjne i nie wymagające dużych nakładów. W obecnym projekcie stworzyliśmy w 3 osoby platformę danych złożoną z ponad 600 tabel i prawie 100 raportów. To zdumiewające, że potrzbowaliśmy do tego zaledwie kilka miesięcy. Pracy było co nie miara ale satysfakcja z wykonanej roboty była ogromna. Polecam Ci zapoznanie się z detalami i oczekujcie kolejnych artykułów powiązanych z poszczególnymi elementami powyższego rozwiązania. Ten artykuł to tylko wstęp. Zapraszam do kolejnych!